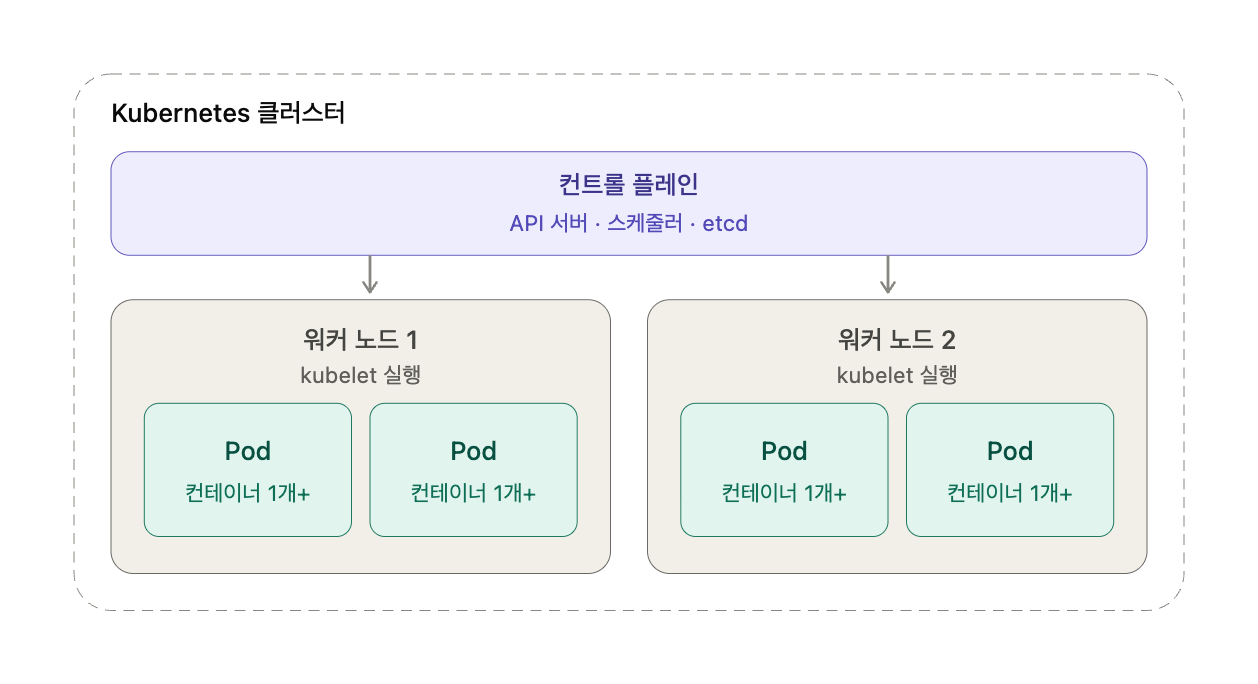
PG사 응답이 느려졌을 뿐인데 결제와 무관한 API까지 멈췄습니다. 스레드 고갈이 일어나는 과정과 타임아웃, 트랜잭션 경계, 벌크헤드, 서킷 브레이커를 순서대로 적용하며 겪은 문제를 정리했습니다.
어느 평일 오후, 결제 API 응답 시간이 올라간다는 알림이 왔습니다. 확인해보니 PG사 쪽이 느려진 상황이었습니다. 우리 잘못은 아니니 원천사 공지를 기다리면 되겠다고 생각했습니다.
4분 뒤, 전혀 예상하지 못한 알림이 이어졌습니다. 앨범 조회 API가 응답하지 않는다는 내용이었습니다. 결제와 아무 관련이 없는 엔드포인트였습니다. 그다음은 로그인이었고, 곧 헬스체크까지 실패했습니다.
외부 시스템 한 곳이 느려졌을 뿐인데 우리 서비스 전체가 멈춰 있었습니다. 이 글은 그날 이후 하나씩 뜯어고치면서, 각 대응책이 어디까지 유효하고 어디서부터 부족했는지를 정리한 기록입니다.
왜 전체가 멈췄을까
원인을 이해하려면 스레드 모델부터 봐야 합니다.
Spring MVC는 요청 하나당 스레드 하나를 배정합니다. 그 스레드는 요청이 끝날 때까지 다른 일을 하지 않습니다. 외부 API 응답을 기다리는 동안에도 마찬가지입니다. CPU는 놀고 있지만 스레드는 점유된 상태입니다.
톰캣의 기본 max-threads는 200입니다. 여기에 리틀의 법칙을 대입해보면 상황이 명확해집니다.
필요한 스레드 수 = 초당 요청 수 × 평균 응답 시간
평소 결제 요청이 초당 50건, 평균 응답이 0.2초였으니 스레드는 10개면 충분했습니다. 그런데 PG 응답이 8초로 늘어나자 계산이 이렇게 바뀝니다.
50 × 8 = 400
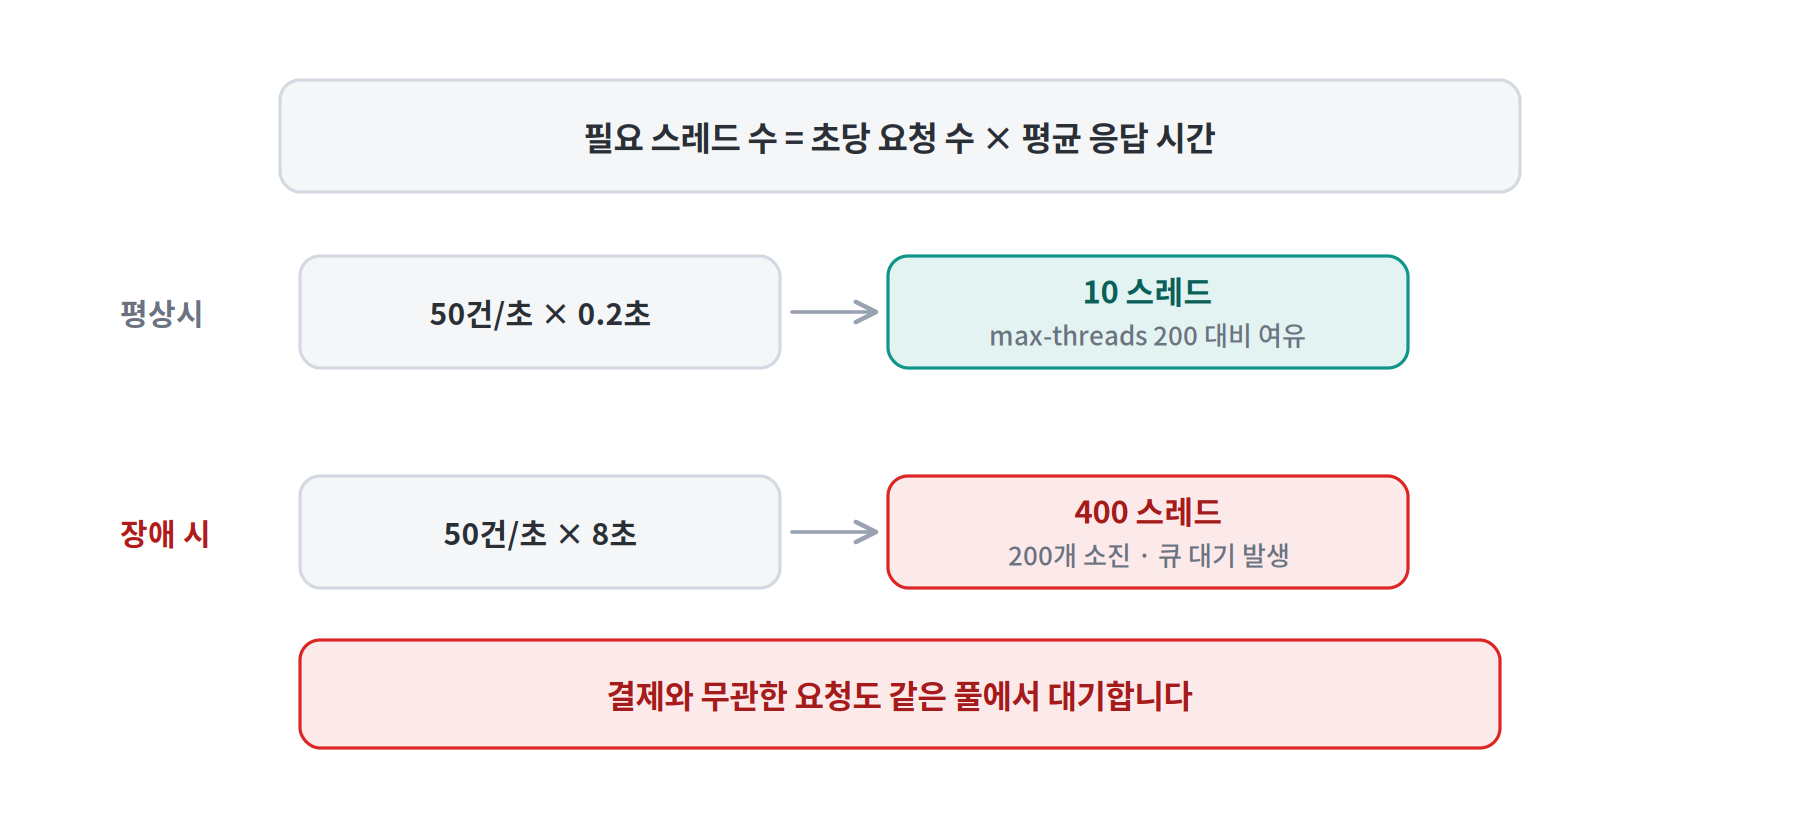
200개로는 감당이 안 됩니다. 스레드가 전부 PG 응답을 기다리는 데 묶이고, 새로 들어온 요청은 큐에서 대기합니다. 그 요청이 앨범 조회인지 결제인지는 상관없습니다. 스레드 풀은 공유 자원이니까요.
이게 첫 번째 답이었습니다. 느린 API 하나가 공유 자원을 전부 점유하면, 그 자원을 쓰는 모든 기능이 같이 죽습니다.
1차 대응: 타임아웃을 건다
가장 먼저 코드를 확인했습니다. 타임아웃 설정이 없었습니다.
@Bean
public RestTemplate restTemplate() {
    return new RestTemplate();   // 타임아웃 없음
}
RestTemplate의 기본 구현인 SimpleClientHttpRequestFactory는 연결 타임아웃과 읽기 타임아웃이 모두 0, 즉 무한 대기입니다. 상대가 응답하지 않으면 우리 스레드는 영원히 기다립니다.
"PG는 보통 1초면 응답한다"는 경험은 정상일 때만 참입니다. 장애 상황에서 상대가 지켜주는 SLA는 없습니다.
@Bean
public RestClient pgRestClient(RestClient.Builder builder) {
    ClientHttpRequestFactorySettings settings = ClientHttpRequestFactorySettings.DEFAULTS
            .withConnectTimeout(Duration.ofSeconds(1))
            .withReadTimeout(Duration.ofSeconds(3));

    return builder
            .requestFactory(ClientHttpRequestFactories.get(settings))
            .baseUrl(pgProperties.getBaseUrl())
            .build();
}
여기서 두 타임아웃의 차이를 짚고 넘어가겠습니다. 헷갈리기 쉬운 부분입니다.
- connect timeout: TCP 연결을 맺기까지 기다리는 시간. 상대 서버가 죽었거나 방화벽에 막히면 여기서 걸립니다.
- read timeout: 연결된 뒤 데이터를 기다리는 시간. 상대가 살아 있지만 느릴 때 걸립니다.
장애 상황에서 실제로 문제가 되는 건 대부분 read timeout 쪽입니다. 서버는 살아 있고 연결도 되는데 응답만 안 오는 상태니까요.
그런데 여기에도 함정이 있습니다.
read timeout은 "정해진 시간 동안 바이트가 하나도 오지 않을 때" 발동합니다. 상대가 1초에 몇 바이트씩 찔끔찔끔 보내면 타임아웃은 영원히 걸리지 않습니다. 실제로 응답 본문이 큰 API에서 이런 경우를 만난 적이 있습니다.
전체 요청에 대한 상한이 따로 필요합니다. Apache HttpClient 5라면 responseTimeout, OkHttp라면 callTimeout이 그 역할을 합니다.
타임아웃만으로는 부족했다
타임아웃을 3초로 걸고 나서 다시 계산해봤습니다.
50 × 3 = 150
200개 중 150개입니다. 아슬아슬하게 버팁니다. 그런데 트래픽이 평소의 1.5배만 돼도 다시 고갈됩니다. 프로모션이 있는 날이면 그냥 넘어갑니다.
여기서 알게 된 게 있습니다. 타임아웃은 장애의 지속 시간을 줄일 뿐, 장애를 격리하지는 않습니다. 스레드가 8초 대신 3초 묶이는 것뿐이지, 여전히 같은 풀을 갉아먹습니다.
진짜 범인은 따로 있었다
그런데 계산이 좀 안 맞았습니다. 초당 50건이면 톰캣 스레드가 소진되는 데 시간이 걸릴 텐데, 실제로는 훨씬 빨리 전체가 멈췄습니다. 로그를 다시 보니 톰캣 스레드보다 먼저 터진 게 있었습니다. DB 커넥션 풀이었습니다.
코드는 이렇게 생겼습니다.
@Transactional
public PaymentResponse pay(PaymentRequest request) {
    Payment payment = paymentRepository.save(Payment.pending(request));

    PgResponse pgResponse = pgClient.approve(request);   // 8초

    payment.complete(pgResponse);
    return PaymentResponse.from(payment);
}
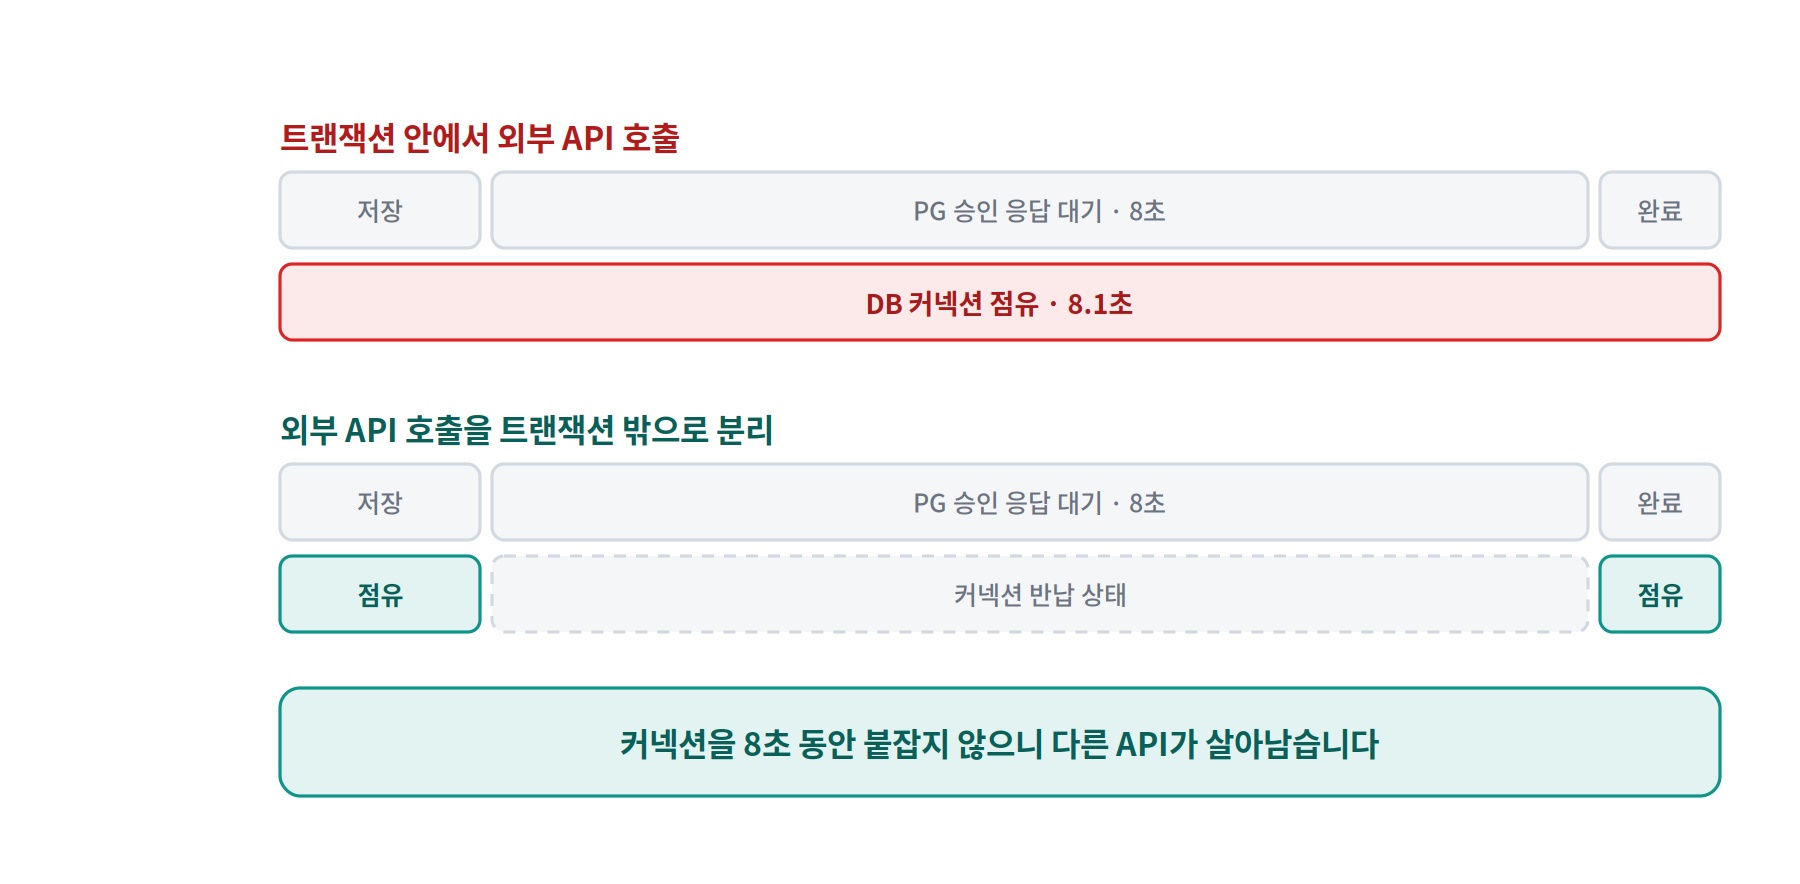
@Transactional이 붙어 있으니 메서드 시작 시점에 DB 커넥션을 하나 가져옵니다. 그리고 메서드가 끝날 때까지 반납하지 않습니다. PG 응답을 8초 기다리는 동안 DB 커넥션도 8초 동안 붙잡혀 있습니다.
HikariCP 기본 풀 사이즈는 10입니다. 결제 요청 10건이 동시에 PG를 기다리기 시작하면 그 순간 커넥션 풀이 비어버립니다. 그리고 DB를 쓰는 모든 API가 커넥션을 못 받습니다.
앨범 조회가 죽은 이유가 여기 있었습니다. 앨범 조회는 톰캣 스레드는 받았지만 DB 커넥션을 기다리다 타임아웃이 났던 겁니다.
고치는 방법은 단순합니다. 외부 호출을 트랜잭션 밖으로 빼는 것입니다.
public PaymentResponse pay(PaymentRequest request) {
    Payment payment = paymentCommandService.createPending(request);   // 짧은 트랜잭션

    PgResponse pgResponse = pgClient.approve(request);                // 트랜잭션 밖

    return paymentCommandService.complete(payment.getId(), pgResponse);   // 짧은 트랜잭션
}
대신 중간 상태가 생깁니다. PENDING으로 저장됐는데 PG 호출 직후 서버가 죽으면 그 건은 붕 뜹니다. 이걸 정리할 배치가 별도로 필요합니다.
이 트레이드오프는 피할 수 없다고 봅니다. 한 트랜잭션으로 묶어서 일관성을 지키려 하면 커넥션이 외부 시스템 응답 시간에 인질로 잡히고, 풀어주면 중간 상태 보정이 필요해집니다. 저희는 후자를 택했습니다. 보정은 배치로 할 수 있지만, 커넥션 고갈은 전사 장애가 되니까요.
그래도 남는 문제: 스레드 격리
DB 커넥션을 지켰어도 톰캣 스레드는 여전히 공유 자원입니다. PG가 느려지면 결제 요청들이 스레드를 계속 점유합니다.
그래서 스레드 풀을 분리했습니다. 배에 격벽을 세워 한 구역이 침수돼도 전체가 가라앉지 않게 하는 것과 같아서 벌크헤드라고 부릅니다.
resilience4j:
  thread-pool-bulkhead:
    instances:
      pgApprove:
        max-thread-pool-size: 20
        core-thread-pool-size: 20
        queue-capacity: 10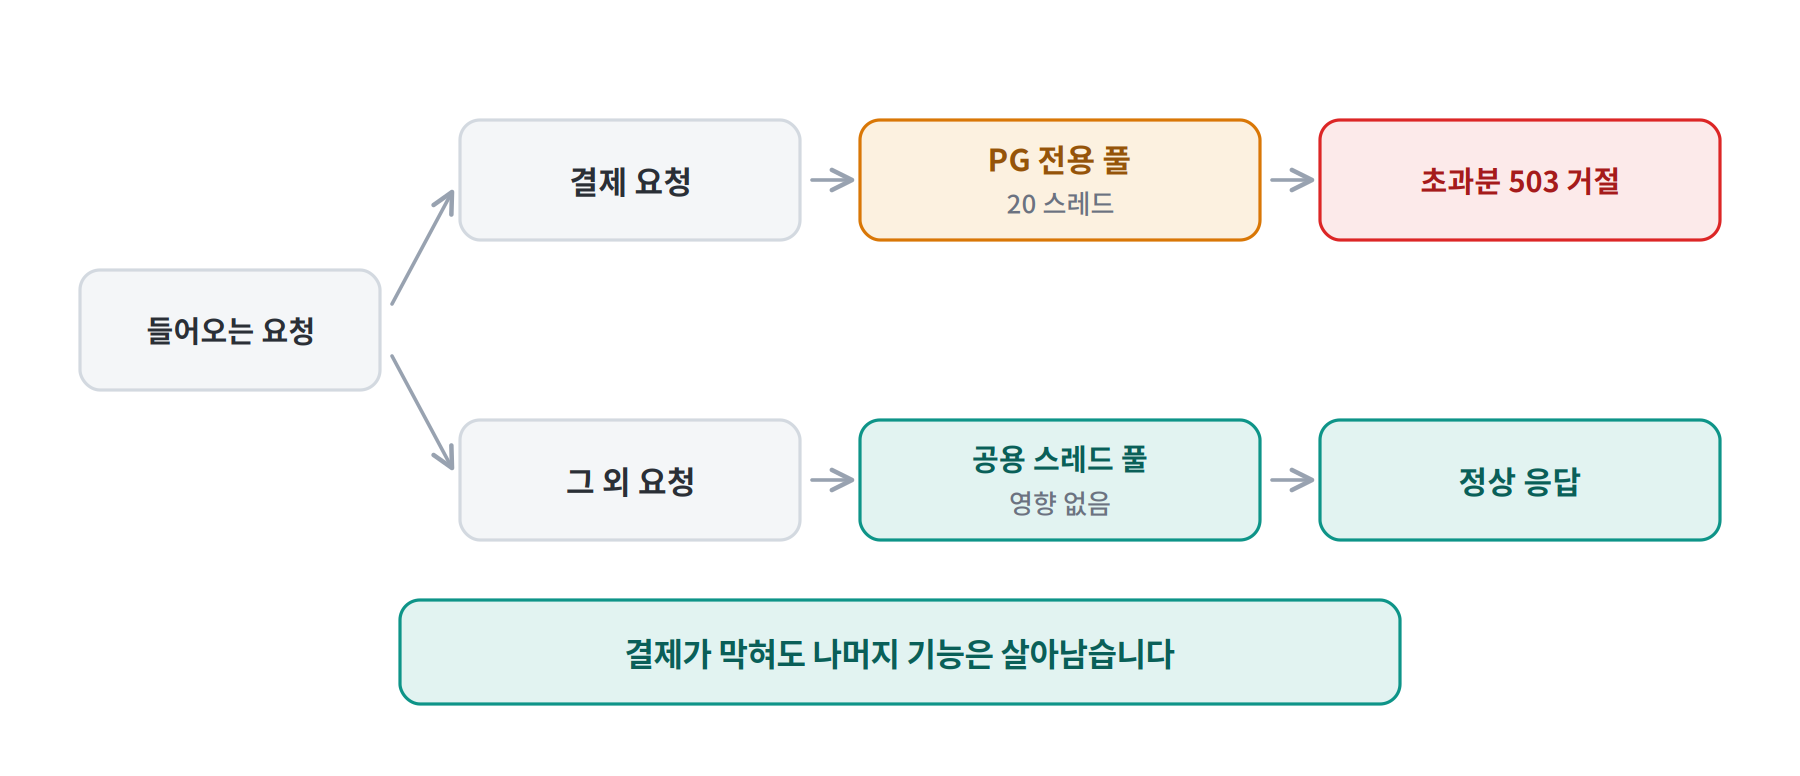
PG 호출은 전용 풀 20개 안에서만 일어납니다. 그 이상은 즉시 거절됩니다. 결제는 실패하더라도 나머지 기능은 살아남습니다.
뚫리는 지점: 거절된 요청을 어떻게 처리할 것인가
벌크헤드가 요청을 거절하면 사용자에게 뭘 보여줄지 정해야 합니다. 여기서 그냥 500을 내려주면 클라이언트가 재시도를 겁니다. 이미 포화된 시스템에 요청이 더 들어옵니다.
명시적인 상태 코드와 함께 재시도 간격을 알려주는 쪽이 낫습니다. 저희는 503에 Retry-After를 실어 보내고, 클라이언트에서는 지수 백오프로 처리하도록 맞췄습니다.
서킷 브레이커는 언제 열어야 하나
마지막 단계입니다. 상대가 계속 실패하는데 계속 호출하는 건 양쪽 모두에게 손해입니다. 일정 비율 이상 실패하면 회로를 열어 아예 시도조차 하지 않습니다.
resilience4j:
  circuitbreaker:
    instances:
      pgApprove:
        sliding-window-type: TIME_BASED
        sliding-window-size: 60
        minimum-number-of-calls: 20
        failure-rate-threshold: 50
        slow-call-duration-threshold: 3s
        slow-call-rate-threshold: 50
        wait-duration-in-open-state: 20s
        permitted-number-of-calls-in-half-open-state: 5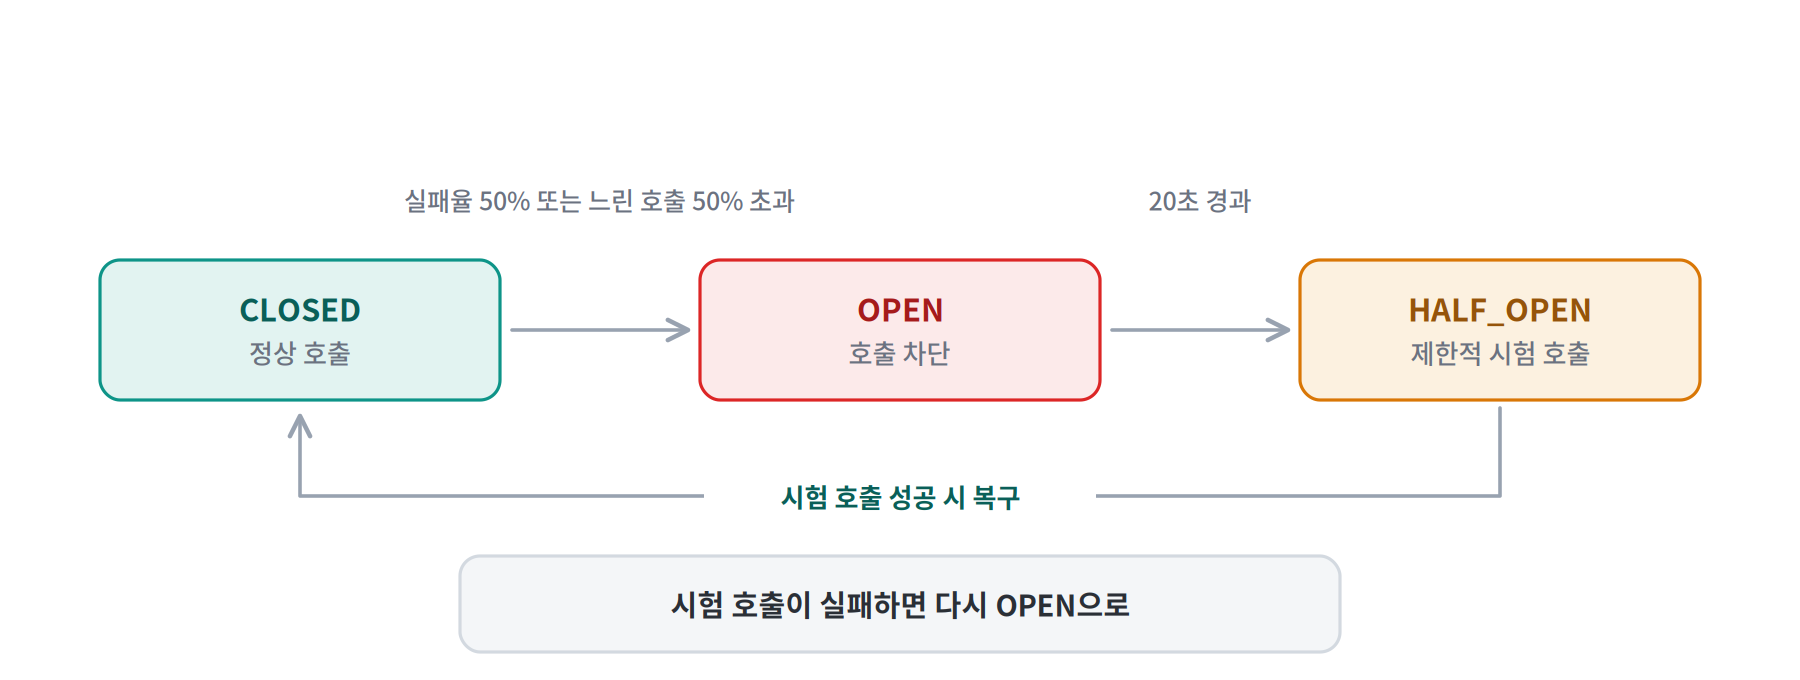
뚫리는 지점 1: 느린 응답은 실패가 아니다
가장 흔한 실수입니다. failure-rate-threshold만 설정해두면, PG가 8초 걸려서 200 OK를 주는 상황에서는 회로가 영원히 안 열립니다. 실패한 게 아니라 느린 것뿐이니까요.
우리를 죽인 건 에러가 아니라 지연이었습니다. slow-call-duration-threshold와 slow-call-rate-threshold를 반드시 같이 설정해야 합니다.
뚫리는 지점 2: 윈도우 크기
너무 크게 잡으면 장애가 한참 진행된 뒤에야 열립니다. 너무 작게 잡으면 일시적인 지연에도 열려서 멀쩡한 결제를 막습니다. minimum-number-of-calls를 같이 조정해서, 호출량이 적은 새벽에 두어 건 실패했다고 회로가 열리는 일을 막아야 합니다.
뚫리는 지점 3: 결제에서 회로를 여는 게 맞는가
이건 기술 문제가 아니라 도메인 판단입니다.
승인 요청은 회로를 열면 매출이 막힙니다. 반대로 열지 않으면 전체 장애로 번집니다. 저희는 엔드포인트마다 다르게 가져갔습니다. 조회성 API는 공격적으로 열고, 승인과 취소는 보수적으로 열되 벌크헤드로 피해 범위를 제한하는 쪽입니다.
뚫리는 지점 4: 폴백이 더 위험할 때가 있다
회로가 열렸을 때 폴백으로 뭘 돌려줄지도 신중해야 합니다. 조회 API라면 캐시된 값을 주면 됩니다. 그런데 결제 승인에 폴백으로 성공을 돌려주면 돈을 안 받고 상품을 주는 코드가 됩니다.
폴백이 없는 게 나은 경우도 있습니다. 실패는 실패로 전달하고, 대신 사용자에게 상황을 정확히 알려주는 편이 안전합니다.
정리하면
각 대응책이 담당하는 구간이 다릅니다.
| 타임아웃 | 무한 대기 | 자원 점유 자체 |
| 트랜잭션 분리 | DB 커넥션 고갈 | 톰캣 스레드 고갈 |
| 벌크헤드 | 장애 전파 | 해당 기능의 장애 |
| 서킷 브레이커 | 무의미한 재시도 | 상대의 복구 |
이 중 하나만 적용하면 반드시 다른 곳에서 터집니다. 저희도 타임아웃만 걸고 끝냈다고 생각했다가 커넥션 풀에서 다시 만났습니다.
Lesson & Learn
외부 호출은 트랜잭션 안에 두지 마세요. 이 한 줄이 그날 장애의 절반이었습니다. 코드 리뷰에서 @Transactional 메서드 안에 HTTP 클라이언트 호출이 있으면 무조건 짚고 넘어가는 규칙을 만들었습니다.
기본값을 믿지 마세요. RestTemplate의 타임아웃은 무한이고, HikariCP 풀은 10개이고, 톰캣 스레드는 200개입니다. 이 숫자들을 한 번도 확인하지 않고 운영하는 서비스가 생각보다 많습니다. 저희도 그랬습니다.
장애는 에러가 아니라 지연으로 옵니다. 에러는 빨리 실패하니 오히려 다루기 쉽습니다. 무서운 건 응답이 오긴 오는데 느린 경우입니다. 모니터링도 에러율만 보면 놓칩니다. p99 응답 시간과 스레드 풀 사용률을 같이 보셔야 합니다.
부하 테스트에 "느린 상대"를 넣으세요. 응답을 10초 지연시키는 목 서버를 하나 띄워두고 돌려보면, 어디가 먼저 터지는지 15분이면 알 수 있습니다. 실제 장애를 기다릴 필요가 없습니다.
읽어주셔서 감사합니다. 비슷한 장애를 겪으셨거나 다르게 푸신 경험이 있다면 댓글로 공유해주시면 좋겠습니다.
'Dev Log' 카테고리의 다른 글
| 멱등키를 어디에 저장할 것인가 — Redis, DB, 그리고 파티션 테이블의 함정 (0) | 2026.09.15 |
|---|---|
| 다중화된 서버에서 중복 요청을 막는 다섯 가지 방법, 그리고 각각이 뚫리는 지점 (0) | 2026.09.14 |